Fish Audio Drama 3: 여러 화자의 대사와 음성 수정을 다루는 TTS
다중 화자와 음성 편집을 겨냥한 Drama 3의 구조를 다이어그램 2장으로 살펴봅니다. 엔진별 API 차이, GPU 메모리, 한국어 평가 항목과 상업 이용 조건을 함께 정리했습니다.
여러 인물이 등장하는 대화 음성을 만들려면 목소리만 바꾸는 것으로 끝나지 않는다. 말하는 사람을 구분하고, 대사의 감정을 조절하고, 잘못 읽은 부분을 고친 뒤에도 장면의 흐름이 유지되어야 한다.
Fish Audio Drama 3는 이런 다중 화자 장면과 긴 콘텐츠 제작을 겨냥한 음성 생성 모델이다. 참조 음성으로 목소리를 지정하고, 대본에 화자와 발화 지시를 넣으며, 이전 생성 결과를 바탕으로 수정하는 기능을 제시한다.
한국어 수업용 대화, 캐릭터 대사, 영상 내레이션을 만드는 입장에서는 관심을 가질 만하다. 다만 모델이 지원하는 기능과 실제 API에서 사용할 수 있는 기능, 실행에 필요한 GPU를 따로 확인해야 한다.
2026년 10월 19일 공식 모델 카드, 기술 보고서 개요, SGLang-Omni·vLLM-Omni 문서와 LICENSE를 확인했다. 이 글은 문서 분석이며, 직접 음성을 생성해 청취 평가한 사용기는 아니다.
1. Drama 3가 하려는 일
기술 보고서는 다중 화자의 장면 생성, 자연어 연출 지시, 여러 차례의 수정, 기존 음성 구간을 채우는 편집, 장문과 스트리밍 생성을 다룬다. 특히 이전 테이크를 맥락으로 삼아 다시 생성하는 방식이 눈에 띈다.
예를 들어 내레이션의 날짜 하나가 바뀌었다면 문장을 수정하고 다시 생성할 수 있다. 여기서 확인할 것은 새 날짜의 발음뿐 아니라, 앞뒤 목소리와 속도·억양이 자연스럽게 이어지는지다. “편집 지원”이 다른 부분의 파형을 그대로 보존한다는 보장은 아니다.
또한 보고서에서 말하는 **음성 구간 채우기(infilling)**와 모델 카드의 이전 테이크를 이용한 이어 생성은 구분해야 한다. 필요한 편집 방식이 자신이 쓰는 서버의 요청 형식으로 제공되는지 확인해야 한다.
근거: Fish Audio Drama 3 기술 보고서.
2. 전체 35B, 활성 3B는 무슨 뜻인가
공식 설명의 백본은 전체 35B, 토큰당 활성 약 3B인 MoE 모델이다. MoE는 여러 전문가 네트워크 중 일부를 선택해 계산하는 구조다. 전체 어텐션과 선형 어텐션을 결합한다.
그 뒤의 Codebook-MTP 디코더가 음성 프레임을 구성하는 10개 코드북을 예측한다. 코드북은 음성을 압축해서 표현하기 위한 코드들의 집합으로 이해하면 된다. 마지막에는 이 표현을 실제 소리의 파형으로 복원한다.

그림 1. 공식 설명을 바탕으로 다시 그린 개념도. 입력 전처리와 세부 텐서 흐름은 생략했다.
화자 표시는 <|speaker:0|>부터 <|speaker:15|>까지 제공된다. 한 텍스트에서 최대 16명의 화자를 구분하는 방식이다. 이것이 16개 독립 음성 트랙이나 모든 인물의 품질 보장을 뜻하지는 않는다.
대본은 다음처럼 구성할 수 있다. 아래는 문법 설명용으로 작성한 예시이며, 한국어 합성 결과를 확인한 샘플은 아니다.
<|speaker:0|> 오늘 발표 준비는 끝났어요?
<|speaker:1|> 거의 끝났어요. [laughs] 조금만 더 연습하면 돼요.
대괄호 지시는 웃음이나 말투를 전달하고, 화자 토큰은 누가 말하는지 구분한다. 태그를 넣은 뒤 실제 소리가 의도대로 나오는지는 청취로 확인해야 한다.
근거: 공식 모델 카드.
3. SGLang과 vLLM에서 같은 기능을 쓸 수 있나
현재 문서 기준으로는 차이가 있다.
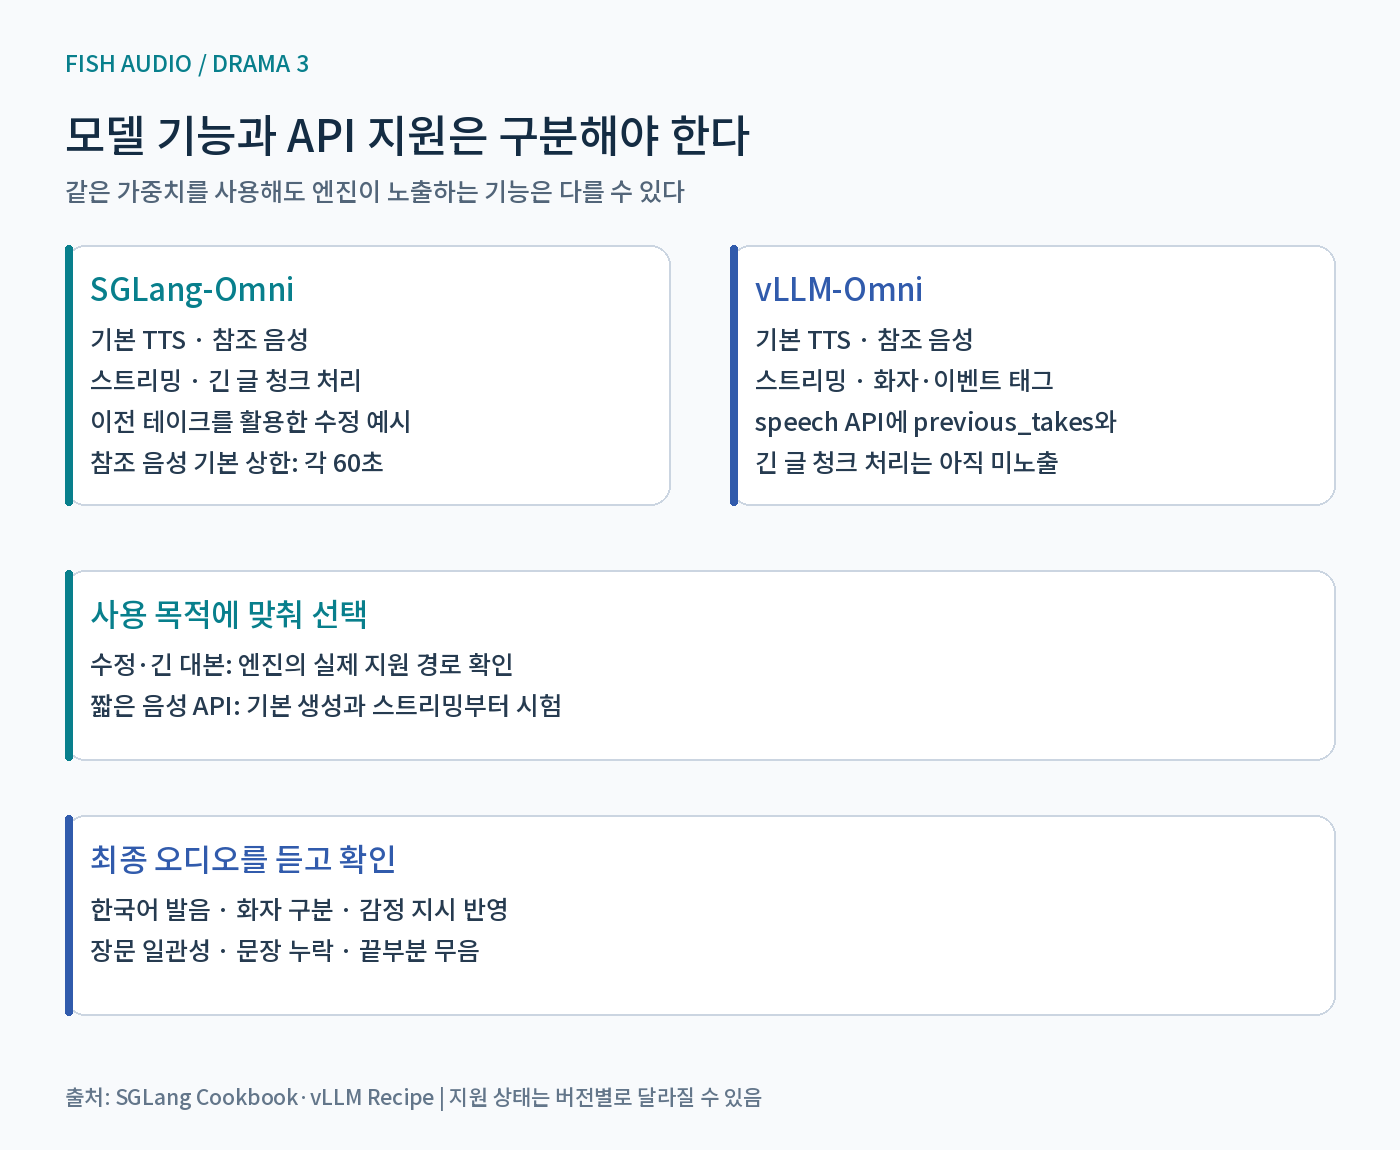
그림 2. 배포 엔진별 문서에서 확인한 지원 범위. 버전이 바뀌면 다시 확인해야 한다.
vLLM-Omni 레시피는 기본 TTS, 참조 음성, 스트리밍, 화자·이벤트 태그를 안내한다. 반면 previous_takes를 이용한 이어 생성 편집과 긴 글 청크 처리는 현재 speech API에 노출되지 않았다고 명시한다.
같은 문서는 대본 첫머리의 이벤트 태그나 추임새 뒤에 긴 무음이 생기는 경우도 기록한다. 태그를 문장 중간에 놓는 편이 더 안정적이라고 설명한다.
SGLang-Omni Cookbook에는 긴 글 처리와 이전 테이크를 활용한 수정 예시가 있다. 참조 음성은 기본적으로 하나당 60초 제한이며, 길이를 늘리면 전처리 메모리도 함께 고려해야 한다.
수정 기능이 목적이라면 가중치를 받기 전에 API 예시부터 보는 것이 좋다. 단순 음성 생성이 되었다고 편집 기능까지 사용할 수 있다고 판단하면 안 된다.
근거: SGLang-Omni Cookbook, vLLM-Omni Recipe.
4. 개인 GPU에서 실행할 수 있을까
활성 파라미터 3B는 GPU 메모리가 일반 3B 모델 수준이라는 뜻이 아니다. 선택되지 않은 전문가의 가중치도 저장하고 관리해야 한다.
| 배포 자료 | 문서에 제시된 조건·측정값 |
|---|---|
| 기본 vLLM-Omni 레시피 | 48GB 이상 CUDA GPU, 참조 실행은 H100 80GB |
| SGLang 기본 체크포인트 | 엔진 가중치 메모리 37.0GB |
| SGLang INT4 체크포인트 | 엔진 가중치 메모리 20.8GB |
INT4의 20.8GB는 가중치만의 메모리다. KV 캐시, 음성 전처리, 보코더 등도 공간을 사용하므로 이를 근거로 “24GB GPU에서 전체 서버가 여유 있게 돌아간다”고 말할 수는 없다.
속도 수치도 조건이 붙는다. 모델 카드의 H200 한 장, 동시 요청 1개 실험에서는 첫 오디오까지의 중앙값이 88.9ms, 평균 RTF가 0.131이다. 영어 프롬프트와 미리 인코딩한 참조 음성을 사용한 제공 측 측정이다.
RTF는 생성에 걸린 시간을 결과 음성 길이로 나눈 값이다. 1보다 작으면 해당 조건에서 재생 시간보다 빠르게 생성했다는 뜻이다. 이 결과를 한국어 장문이나 다른 GPU의 지연으로 그대로 옮길 수는 없다.
근거: 모델 카드의 서빙 측정, SGLang 메모리·양자화 설명, vLLM 실행 조건.
5. 가장 먼저 실행할 작은 예제
vLLM 레시피의 설치 경로는 다음과 같다. uv와 호환 CUDA 환경을 준비한 뒤 실행하는 안내이며, 여기서 직접 설치를 검증하지는 않았다.
uv venv
source .venv/bin/activate
uv pip install vllm==0.31.0 --torch-backend=auto
uv pip install git+https://github.com/vllm-project/vllm-omni.git
vllm serve fishaudio/drama-3 --omni --port 8000
첫 요청에는 커널 컴파일 시간이 들어갈 수 있다. 서버 시작 직후의 응답 시간을 정상 상태의 지연으로 판단하지 않는다.
다음은 SGLang Cookbook이 안내하는 기본 요청 형식으로, SGLang 서버를 8000번 포트에서 실행한 경우의 예시다. 두 엔진의 참조 음성 필드 등을 섞지 않도록 별도로 표시했다.
curl http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"input":"오늘은 도서관에서 친구를 만났어요."}' \
  --output sample.wav
SGLang 서버 실행은 해당 저장소의 설치 안내를 따른 뒤 아래 명령을 사용한다.
sgl-omni serve --model-path fishaudio/drama-3 --port 8000
처음에는 짧은 문장 하나로 발음과 종료 동작을 확인하고, 이후 두 화자 대화와 긴 대본으로 늘리는 편이 문제를 찾기 쉽다. 목소리 복제에는 사용할 권한이 있는 참조 음성을 준비한다.
6. 한국어 수업·영상 제작에서는 무엇을 확인해야 하나
공개된 영어 예제가 자연스럽더라도 한국어 수업에 바로 적합하다고 판단할 수는 없다. 같은 짧은 대본을 여러 번 생성하고 다음 항목을 비교해 볼 수 있다.
| 용도 | 확인할 내용 |
|---|---|
| 초급 한국어 듣기 | 받침·연음, 숫자와 시간 읽기, 지나치게 빠른 말속도 |
| 두 사람의 대화 | 화자 전환, 목소리 구분, 문장 사이의 간격 |
| 캐릭터 대사 | 웃음·속삭임이 대사를 가리지 않는지 |
| 긴 내레이션 | 문장 누락, 반복, 구간 사이의 음색·크기 변화 |
| 대사 수정 | 수정한 단어뿐 아니라 앞뒤 연결도 자연스러운지 |
교육용 음성이라면 감정 표현의 풍부함보다 학습자가 문장을 정확히 들을 수 있는지가 먼저다. “오후 세 시 삼십 분”처럼 숫자와 단위를 포함한 문장, 질문과 대답이 이어지는 대화를 시험해 보면 실제 쓰임을 판단하기 좋다.
이 표는 도입 평가를 위한 제안이다. Drama 3의 한국어 성능을 실측한 결과는 아니다.
7. 공개 가중치와 상업 이용 조건
Drama 3는 Apache-2.0이나 MIT 모델이 아니다. 연결된 LICENSE 파일은 Fish Audio Community License 1.0이며, Hugging Face 상단 메타데이터의 이름과 다르게 표시되는 부분이 있어 원문을 확인해야 한다.
문서상 연 매출 50만 달러 미만에는 조건부 상업 이용 허용이 있다. 매출은 모델 관련 매출만이 아니라 관계사를 포함한 전체 매출 기준으로 정의되어 있다.
하지만 제3자가 자신의 텍스트나 음성을 넣어 생성하는 Hosted Service는 매출 규모와 무관하게 별도 계약 대상으로 규정된다. 단, 원문에는 비상업 연구 데모 등의 예외가 있다.
자신이 통제하는 콘텐츠의 내레이션, 앱 캐릭터 음성, 완성된 음성 파일만 납품하는 제작 업무는 Hosted Service의 예외 사례로 설명된다. 이런 용도도 나머지 상업 이용 조건과 표시 의무를 확인해야 한다. 관련 제품·서비스 등에 “Built with Fish Audio” 표시를 요구하는 조항도 있다.
따라서 영상 제작에 쓰는 것과 누구나 대본을 입력하는 음성 생성 사이트를 운영하는 것은 같은 조건이 아니다.
근거: 공식 LICENSE 원문, 2026년 10월 13일 갱신본.
처음 시험한다면 두 사람이 네 문장씩 주고받는 짧은 대화가 적당하다. 기본 생성으로 발음과 화자 구분을 확인하고, 같은 대본에 감정 지시를 추가한 뒤 결과를 비교한다. 마지막에 한 문장만 수정해 앞뒤 연결을 들어보면, Drama 3가 자신의 제작 과정에서 줄여 줄 작업이 무엇인지 판단할 수 있다.
공식 링크: 모델 · 기술 보고서 · Fish Audio
다이어그램 두 장은 공식 문서를 바탕으로 작성한 해설 이미지다.