RAG 03. 개인 메모 검색기: 수정한 내용은 갱신하고 지운 메모는 없애기
Markdown 메모를 태그와 제목으로 검색하고, 파일 해시로 수정·삭제를 반영하는 로컬 색인을 만듭니다.
메모 파일을 고쳤는데 검색에는 옛 문장이 계속 나오고, 지운 메모도 결과에 남는다면 검색기를 믿기 어렵습니다. 이번에는 Markdown 메모를 검색하면서 수정과 삭제까지 반영하는 작은 색인을 만듭니다.
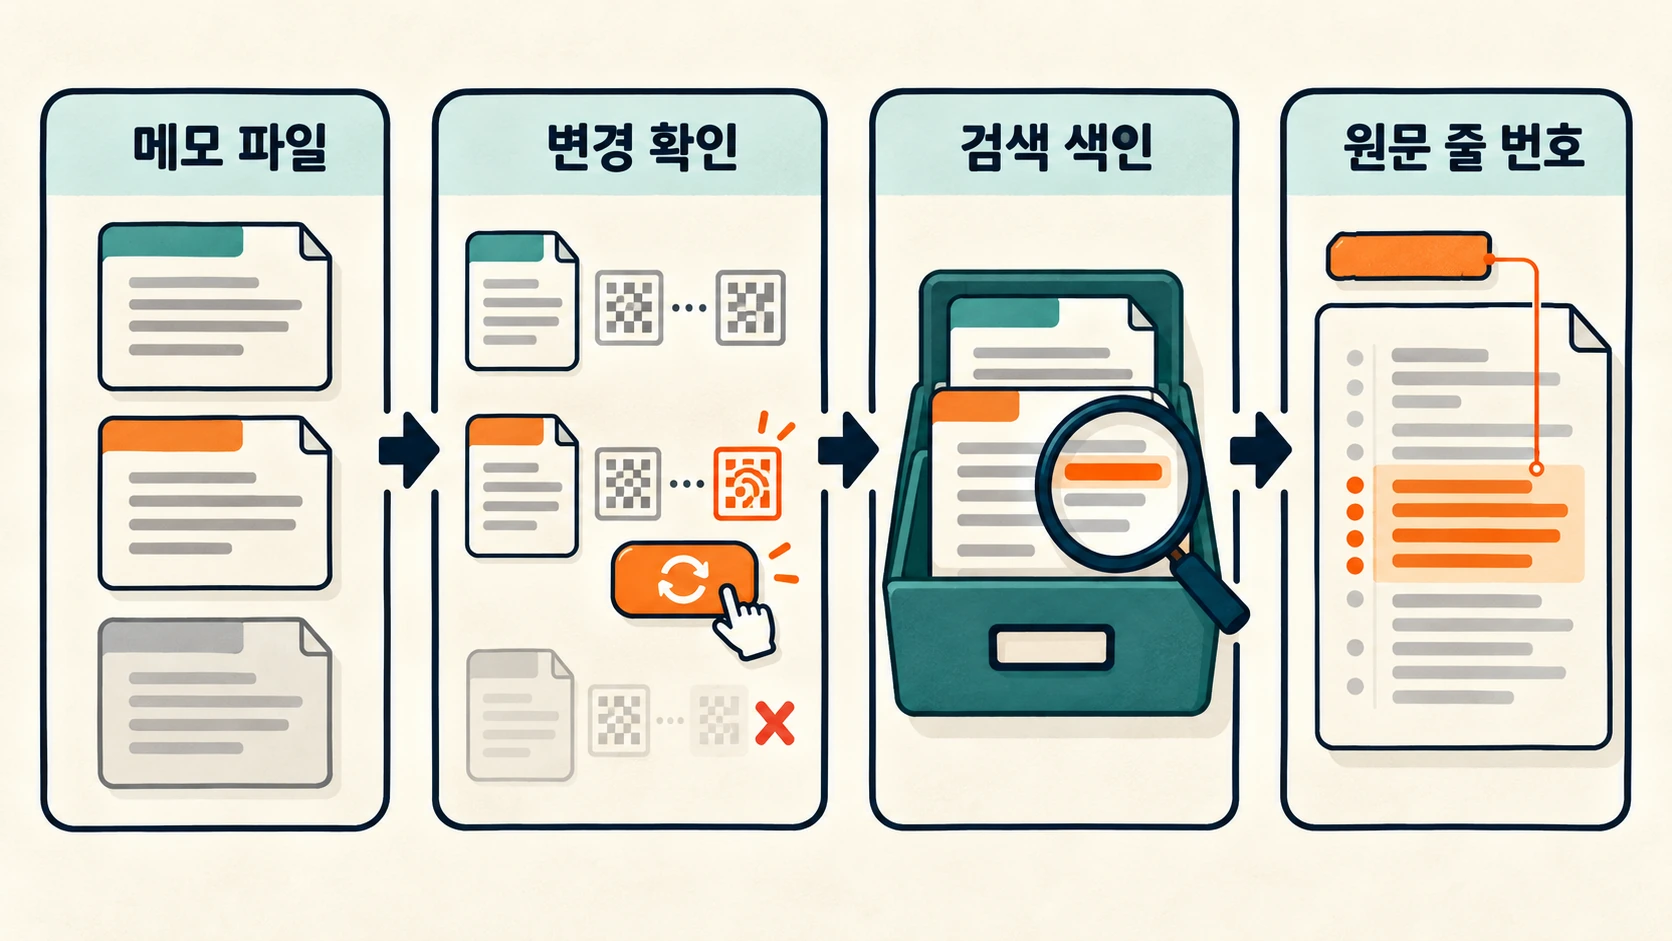
그림은 처리 과정을 설명하는 개념도입니다. 실제 화면이나 처리 속도 측정 결과가 아닙니다.
오늘 만들 결과
“캐시”를 검색하면 메모의 해당 문단과 파일명, 제목, 줄 번호가 나옵니다. rag 태그로 범위를 좁힐 수 있고, 수정된 파일만 다시 문단으로 나눕니다. 삭제한 파일의 흔적은 다음 색인 갱신 때 제거합니다.
이번 편은 RAG의 검색 기반을 만드는 실습입니다. 언어 모델이 답을 생성하지 않으며 외부 API도 사용하지 않습니다. 생성 모델을 연결하기 전에, 모델에게 전달할 근거가 최신 상태인지부터 확인합니다.
색인(index)은 검색에 쓰기 좋게 정리해 둔 자료입니다. 여기서는 파일별 원문 조각과 메타데이터를 담은 index.json입니다. 벡터 데이터베이스나 임베딩 모델은 쓰지 않습니다. 검색 점수는 본문과 제목에 같은 단어가 등장하는지를 셉니다.
1. 메모 세 개 준비하기
Python 3.12와 표준 라이브러리만 사용합니다. 이전 편의 파일은 필요 없습니다. 빈 실습 폴더 안에 notes 폴더를 만들고 아래 세 파일을 저장하세요. 예제 내용은 모두 가상의 메모입니다.
notes/cache.md:
# 검색 메모
 tags: rag, backend

## 캐시 무효화
문서 내용이 바뀌면 SHA-256 해시를 비교해 해당 파일의 청크를 다시 만듭니다.
삭제한 문서의 청크도 색인에서 제거합니다.

## 재시도
일시적인 네트워크 오류에는 대기 시간을 늘리며 재시도합니다.
notes/reading.md:
# 읽을거리 메모
 tags: reading

## 캐시
캐시 개념을 정리한 글을 다음 주에 읽습니다.
notes/meeting.md:
# 가상 회의 메모
 tags: backend

## 배포
실습용 검색기는 변경된 메모만 다시 읽도록 구현합니다.
이 실습의 메모 규칙은 간단합니다. tags: 줄을 본문보다 먼저 적고, 쉼표로 태그를 나눕니다. #로 시작하는 줄은 제목이며, 빈 줄을 기준으로 본문 조각을 만듭니다. 일반 Markdown 전체 문법을 구현한 파서는 아닙니다. 코드 블록 안의 #까지 제목으로 볼 수 있으므로 복잡한 개발 노트를 넣을 때는 정식 Markdown 파서로 바꿔야 합니다.
2. 수정·삭제를 반영하는 색인 만들기
notes_search.py로 저장합니다.
import argparse
import hashlib
import json
import re
from pathlib import Path


def words(text):
    return set(re.findall(r'[a-z0-9가-힣]+', text.lower()))


def parse_note(text, relative_path):
    chunks, lines, tags = [], [], []
    heading, start = relative_path, 0

    def flush(end):
        if lines:
            chunks.append({'id': f'{relative_path}:L{start}',
                           'path': relative_path, 'heading': heading,
                           'start': start, 'end': end,
                           'tags': tags.copy(), 'text': '\n'.join(lines)})
            lines.clear()

    for number, line in enumerate(text.splitlines(), 1):
        stripped = line.strip()
        if stripped.startswith('tags:'):
            if chunks or lines:
                raise ValueError('tags는 본문보다 먼저 한 줄에 적으세요.')
            tags = [tag.strip() for tag in stripped[5:].split(',') if tag.strip()]
        elif stripped.startswith('#'):
            flush(number - 1)
            heading = stripped.lstrip('#').strip()
        elif not stripped:
            flush(number - 1)
        else:
            if not lines:
                start = number
            lines.append(line)
    flush(len(text.splitlines()))
    return chunks


def build_index(root, destination):
    root, destination = Path(root).resolve(), Path(destination)
    old = json.loads(destination.read_text(encoding='utf-8')) if destination.exists() else {}
    previous = old.get('files', {}) if old.get('root') == str(root) else {}
    current, changed = {}, 0
    for path in sorted(root.rglob('*.md')):
        if path.is_symlink() or not path.is_file():
            continue
        relative = path.relative_to(root).as_posix()
        raw = path.read_bytes()
        digest = hashlib.sha256(raw).hexdigest()
        if previous.get(relative, {}).get('sha256') == digest:
            current[relative] = previous[relative]
        else:
            current[relative] = {'sha256': digest,
                                'chunks': parse_note(raw.decode('utf-8'), relative)}
            changed += 1
    removed = len(previous.keys() - current.keys())
    document = {'version': 1, 'root': str(root), 'files': current}
    temporary = destination.with_suffix(destination.suffix + '.tmp')
    temporary.write_text(json.dumps(document, ensure_ascii=False, indent=2), encoding='utf-8')
    temporary.replace(destination)
    return changed, removed


def search(index_path, question, tag=None, limit=3):
    data = json.loads(Path(index_path).read_text(encoding='utf-8'))
    query, ranked = words(question), []
    for file in data['files'].values():
        for chunk in file['chunks']:
            if tag is not None and tag not in chunk['tags']:
                continue
            score = len(query & words(chunk['text'])) + 2 * len(query & words(chunk['heading']))
            if score:
                ranked.append((score, chunk))
    ranked.sort(key=lambda pair: (-pair[0], pair[1]['path'], pair[1]['start']))
    return [chunk for _, chunk in ranked[:limit]]


def main():
    parser = argparse.ArgumentParser()
    commands = parser.add_subparsers(dest='command', required=True)
    index = commands.add_parser('index')
    index.add_argument('folder')
    index.add_argument('--out', default='index.json')
    query = commands.add_parser('search')
    query.add_argument('question')
    query.add_argument('--index', default='index.json')
    query.add_argument('--tag')
    args = parser.parse_args()
    if args.command == 'index':
        changed, removed = build_index(args.folder, args.out)
        print(f'갱신 파일: {changed}, 제거 파일: {removed}')
        return
    hits = search(args.index, args.question, args.tag)
    for hit in hits:
        print(f"[{hit['id']}] {hit['heading']} (L{hit['start']}–L{hit['end']})\n{hit['text']}")
    if not hits:
        print('일치하는 메모를 찾지 못했습니다.')


if __name__ == '__main__':
    main()
핵심은 build_index의 previous와 current입니다. 기존 파일 목록을 읽되, 이번에 실제로 발견한 파일만 current에 넣습니다. 더 이상 존재하지 않는 파일은 새 목록에 들어가지 않으므로 검색에서도 사라집니다. 파일을 지웠다는 사실을 별도 이벤트로 전달할 필요가 없습니다.
각 파일은 SHA-256 해시로 비교합니다. 해시는 내용에서 계산한 짧은 값이며, 이 예제에서는 내용이 달라졌는지 판단하는 표식으로 씁니다. Python hashlib 문서에서 사용하는 sha256과 hexdigest를 확인할 수 있습니다.
해시가 같으면 이전에 나눠 둔 조각을 재사용합니다. 다만 모든 파일의 바이트를 읽어 해시를 다시 계산하므로, “바뀌지 않은 파일을 전혀 읽지 않는다”는 뜻은 아닙니다. 줄인 작업은 문단 분할입니다. 큰 폴더에서 얼마나 빨라지는지는 이 글에서 측정하지 않았습니다.
새 JSON은 임시 파일에 완성한 뒤 기존 색인을 교체합니다. 이것은 직접 덮어쓰는 도중 내용이 잘리는 위험을 줄입니다. 여러 프로세스가 동시에 갱신하는 잠금 처리나 디스크 장애 복구까지 제공하지는 않습니다. 한 사람이 한 프로세스로 실행하는 실습 범위입니다.
3. 색인을 두 번 만들고 검색하기
첫 실행 전에 현재 폴더에 index.json이 없는지 확인합니다. 색인 파일에는 메모 본문과 폴더 경로가 복사됩니다. 실제 개인 메모를 사용한다면 이 파일도 원본처럼 보호해야 합니다.
python notes_search.py index notes
python notes_search.py index notes
python notes_search.py search "캐시" --tag rag
로컬에서 실제 실행한 결과입니다.
갱신 파일: 3, 제거 파일: 0
갱신 파일: 0, 제거 파일: 0
[cache.md:L5] 캐시 무효화 (L5–L6)
문서 내용이 바뀌면 SHA-256 해시를 비교해 해당 파일의 청크를 다시 만듭니다.
삭제한 문서의 청크도 색인에서 제거합니다.
두 번째 색인 생성에서 갱신 파일이 0인 것을 확인합니다. reading.md에도 “캐시”가 있지만 rag 태그가 없어서 검색 후보에서 제외됩니다. 제목의 단어에는 본문보다 높은 가중치 2를 주었습니다. 이것은 실습용 규칙이며 통계적으로 최적화한 값이 아닙니다.
없는 단어를 찾으면 결과가 비어 있습니다.
python notes_search.py search "우주선"
일치하는 메모를 찾지 못했습니다.
파일을 고친 뒤에는 index 명령을 다시 실행해야 합니다. 현재 프로그램은 폴더를 실시간 감시하지 않습니다. search는 저장된 스냅샷만 읽으므로 갱신 전 줄 번호와 내용은 옛 버전을 가리킬 수 있습니다.
4. 변경과 삭제를 테스트로 확인하기
test_notes.py로 저장합니다. 테스트는 원본 notes 폴더를 임시 폴더로 복사하므로 실습 메모를 실제로 지우지 않습니다.
import shutil
import tempfile
import unittest
from pathlib import Path
from notes_search import build_index, parse_note, search


class NoteTests(unittest.TestCase):
    def setUp(self):
        self.temp = tempfile.TemporaryDirectory()
        self.addCleanup(self.temp.cleanup)
        self.root = Path(self.temp.name) / 'notes'
        shutil.copytree('notes', self.root)
        self.index = Path(self.temp.name) / 'index.json'

    def test_first_and_unchanged_build(self):
        self.assertEqual(build_index(self.root, self.index), (3, 0))
        self.assertEqual(build_index(self.root, self.index), (0, 0))

    def test_tag_and_source_lines(self):
        build_index(self.root, self.index)
        hits = search(self.index, '캐시', 'rag')
        self.assertEqual(len(hits), 1)
        self.assertEqual((hits[0]['path'], hits[0]['start'], hits[0]['end']), ('cache.md', 5, 6))

    def test_changed_text_replaces_old_text(self):
        build_index(self.root, self.index)
        file = self.root / 'cache.md'
        file.write_text(file.read_text(encoding='utf-8').replace('SHA-256', 'content-id'), encoding='utf-8')
        self.assertEqual(build_index(self.root, self.index), (1, 0))
        self.assertEqual(search(self.index, 'SHA'), [])
        self.assertTrue(search(self.index, 'content'))

    def test_deleted_file_disappears(self):
        build_index(self.root, self.index)
        (self.root / 'cache.md').unlink()
        self.assertEqual(build_index(self.root, self.index), (0, 1))
        self.assertEqual(search(self.index, '캐시', 'rag'), [])

    def test_unknown_query(self):
        build_index(self.root, self.index)
        self.assertEqual(search(self.index, '우주선'), [])

    def test_tags_after_body_are_rejected(self):
        with self.assertRaises(ValueError):
            parse_note('# 제목\n본문\ntags: late', 'bad.md')


if __name__ == '__main__':
    unittest.main()
python -m unittest -v
Python 3.12.14에서 6개 테스트가 통과했습니다. 최초 색인, 변경 없는 재실행, 태그·줄 번호, 수정 내용 교체, 삭제 반영, 없는 질문, 잘못된 태그 위치를 검사합니다. 파일을 수정한 테스트에서 갱신 개수가 1인지 확인하는 것만으로 끝내지 않고, 예전 단어가 검색에서 사라졌는지도 확인했습니다.
5. 실제 메모를 넣기 전에 알아둘 한계
- 단어 단위 일치이므로 “캐시를”과 “캐시”를 다르게 봅니다. 형태소 분석이나 의미 검색은 별도로 붙여야 합니다.
- 메모 제목은 현재 문단의 가장 가까운 제목만 저장합니다. 상위 제목의 계층도 필요하면 제목 스택을 만들어 보존해야 합니다.
- 파서 규칙을 수정해도 원본 파일의 해시는 그대로입니다. 이때는 색인을 새 경로로 생성하거나 기존 색인을 재구축해야 합니다. 운영 코드라면
parser_version도 재사용 조건에 포함하세요. - 파일을 이름만 바꿔도 기존 경로는 삭제, 새 경로는 추가로 처리합니다.
id가 파일 경로와 줄 번호에 연결되어 있기 때문입니다. index.json에는 원문이 들어 있습니다. 개인 메모의 검색 기능을 만들었다고 해서 여러 사용자에게 공유할 권한이 생기지는 않습니다.
직접 바꿔 볼 것
cache.md에 한 문단을 추가하고index를 다시 실행하세요. 갱신 파일은 1이어야 합니다.reading.md를 다른 이름으로 바꾸세요. 새 파일 1개 갱신과 옛 파일 1개 제거가 보고되는지 확인하세요.- 제목 가중치를 2에서 0으로 바꾸고 태그 없이 “캐시”를 검색하세요. 순위가 어떻게 변하는지 원문과 함께 비교하세요.
- 색인에
parser_version을 추가한 뒤 버전이 바뀌면 모든 파일을 재분할하는 테스트를 작성하세요.
검색 정확도는 관련 문서를 찾는 문제만이 아닙니다. 더 이상 유효하지 않은 문서를 결과에서 없애는 일도 포함합니다. 이 기반이 있어야 나중에 생성 모델이 옛 메모를 최신 사실처럼 말하는 일을 줄일 수 있습니다.
참고 자료
- Python 3.12 pathlib: 폴더 탐색, 파일 읽기와 경로 교체
- Python 3.12 hashlib: 내용 해시 계산
- Python 3.12 tempfile: 원본을 건드리지 않는 임시 폴더 테스트
RAG 실전 포트폴리오 03/25
이전: 02. 강의계획서 Q&A: 주차와 평가 기준을 먼저 좁히기