RAG 08. 계약서 조항 검색: 연결된 예외 조항을 빠뜨리지 않기
가상 계약서의 조항을 검색한 뒤 참조된 예외까지 확장합니다. 법률 판단 없이 원문·줄 번호·연결을 보존하는 실습입니다.
계약서에서 “자료 반환 기간”을 찾을 때 14일이라는 문장만 가져오면, 바로 옆에서 참조한 보존 예외를 놓칠 수 있습니다. 이번에는 검색된 조항과 그 조항이 가리키는 다른 조항을 묶어서 보여주는 검색기를 만듭니다.
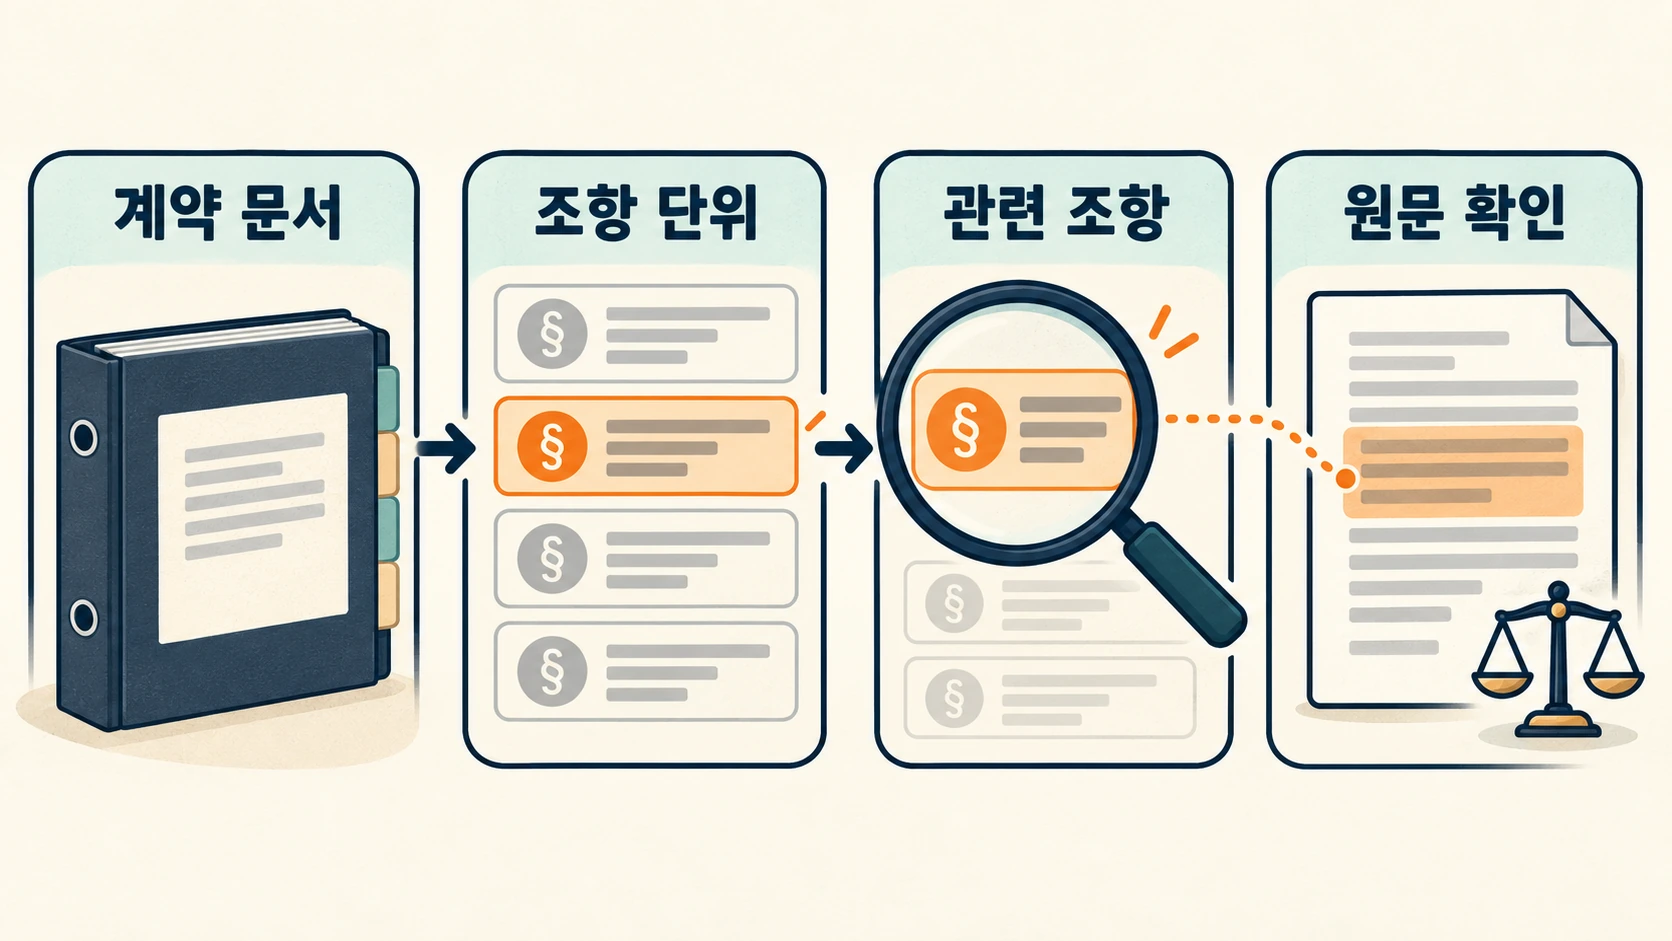
그림은 조항 연결을 설명하는 개념도입니다. 실제 계약 검토 결과나 법률적 정확도 측정값을 나타내지 않습니다.
오늘 만들 결과
아래 출력은 가상 계약서를 대상으로 로컬에서 실행한 결과입니다.
학습용 원문 검색입니다. 법률 판단이 아닙니다.
[C02] 자료 반환 | 검색 일치
contract.txt:7-9
자료 반환 기간은 계약 종료 후 14일이다.
공급자는 전달받은 자료를 반환하고 보유 사본을 삭제한다. 단, @C03의 보존 예외는 함께 확인한다.
[C03] 보존 예외 | C02에서 연결
contract.txt:11-13
양측이 별도 서면 합의로 보존 대상으로 지정한 사본에는 @C02의 일괄 삭제 절차를 적용하지 않는다.
보존 대상과 보존 종료일은 해당 서면 합의에서 정한다.
프로그램은 조항의 법적 효력이나 실제 의무를 판단하지 않습니다. 교육용 텍스트 검색 실습이며, 예제 계약은 직접 만든 허구입니다. 실제 계약에 적용되는 판단은 전체 계약과 상황을 확인할 수 있는 전문가의 검토가 필요합니다.
RAG에서는 검색된 텍스트가 답변의 재료가 됩니다. 따라서 이 편은 재료를 빠뜨리지 않는 데 집중합니다. 언어 모델과 외부 API는 연결하지 않고, 서로 연결된 원문을 정확히 가져오는 단계까지만 구현합니다.
1. 검색 단위와 연결 단위를 나누기
조항 하나를 하나의 청크로 만듭니다. 청크에는 id, 제목, 원문, 파일·줄 번호, 참조 목록을 저장합니다. C02가 C03을 가리킨다면 C02를 검색한 뒤 C03도 가져옵니다. 이것이 이번 실습의 참조 확장입니다.
여기서는 @C03처럼 명시적인 표시를 사용합니다. 실제 문서의 “전항”, “별지”, “제3조 제2항”을 일반적으로 해석하는 파서는 아닙니다. 실습에서 먼저 연결을 확실히 보존하고, 현실 문서에 맞는 추출 규칙은 별도 단계로 다뤄야 합니다.
검색 순위와 조항 연결은 다른 문제입니다. 검색 점수는 질문과 단어가 얼마나 겹쳤는지를 나타냅니다. 조항 연결은 작성자가 붙인 참조를 나타냅니다. 예외 조항의 검색 점수가 낮아도 연결을 통해 가져올 수 있습니다.
2. 가상 계약서 저장하기
Python 3.12와 표준 라이브러리만 사용합니다. 새 폴더에 contract.txt, clause_search.py, test_clause_search.py 세 파일을 저장합니다. 외부 패키지 설치나 이전 편의 코드 복사는 필요하지 않습니다.
contract.txt는 아래 전체 내용을 UTF-8로 저장하세요. C01부터 C04까지는 실습용 id이며 실제 법률 문서의 표준 형식이 아닙니다.
가상 개발 용역 계약서 / 학습용 / 버전 v1
실제 계약이나 법률 자문에 사용하지 않는 예제입니다.

## C01 | 서비스 범위
공급자는 예제 화면 세 개를 구현하고 의뢰자는 검토 의견을 제공한다.

## C02 | 자료 반환
자료 반환 기간은 계약 종료 후 14일이다.
공급자는 전달받은 자료를 반환하고 보유 사본을 삭제한다. 단, @C03의 보존 예외는 함께 확인한다.

## C03 | 보존 예외
양측이 별도 서면 합의로 보존 대상으로 지정한 사본에는 @C02의 일괄 삭제 절차를 적용하지 않는다.
보존 대상과 보존 종료일은 해당 서면 합의에서 정한다.

## C04 | 종료 통지
일반 종료를 원하는 당사자는 7일 전에 상대방에게 서면으로 통지한다.
C02와 C03은 서로를 참조합니다. 무작정 다음 조항을 계속 읽으면 같은 두 조항을 반복할 수 있습니다. 그래서 검색기는 이미 방문한 id를 기록해야 합니다.
3. 조항 파싱과 참조 확장 구현하기
다음을 clause_search.py로 저장합니다.
import argparse
import hashlib
import re
from pathlib import Path

HEADER = re.compile(r'## (C\d+) \| (.+)')
REFERENCE = re.compile(r'@(C\d+)(?![A-Za-z0-9_])')


def tokens(text):
    return set(re.findall(r'[a-z0-9가-힣]+', text.lower()))


def parse_contract(path):
    path = Path(path)
    source = path.read_text(encoding='utf-8')
    lines = source.splitlines()
    starts = []
    for index, line in enumerate(lines):
        match = HEADER.fullmatch(line)
        if match:
            starts.append((index, match.group(1), match.group(2)))
        elif line.startswith('##'):
            raise ValueError(f'Invalid clause heading on line {index + 1}.')
    if not starts:
        raise ValueError('No clause headings found.')
    clauses = {}
    for position, (start, clause_id, title) in enumerate(starts):
        stop = starts[position + 1][0] if position + 1 < len(starts) else len(lines)
        while stop > start + 1 and not lines[stop - 1].strip():
            stop -= 1
        body = '\n'.join(lines[start + 1:stop]).strip()
        if clause_id in clauses or not body:
            raise ValueError('Duplicate clause id or empty clause.')
        clauses[clause_id] = {
            'id': clause_id, 'title': title, 'text': body,
            'file': path.name, 'start': start + 1, 'end': stop,
            'revision': hashlib.sha256(source.encode()).hexdigest()[:12],
            'references': list(dict.fromkeys(REFERENCE.findall(body))),
        }
    for clause in clauses.values():
        missing = set(clause['references']) - clauses.keys()
        if missing:
            raise ValueError(f"{clause['id']} has missing references: {sorted(missing)}")
    return clauses


def retrieve(question, clauses, top_k=1):
    if top_k < 1:
        raise ValueError('top_k must be positive.')
    query = tokens(question)
    def score(clause):
        return (2 * len(query & tokens(clause['title']))
                + len(query & tokens(clause['text'])))
    ranked = sorted(clauses.values(), key=score, reverse=True)
    return [clause['id'] for clause in ranked if score(clause) > 0][:top_k]


def expand_references(roots, clauses):
    queue = [(root, '검색 일치') for root in roots]
    seen = set()
    result = []
    for clause_id, reason in queue:
        if clause_id in seen:
            continue
        seen.add(clause_id)
        clause = clauses[clause_id]
        result.append({**clause, 'reason': reason})
        queue.extend((linked, f'{clause_id}에서 연결')
                     for linked in clause['references'] if linked not in seen)
    return result


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('file', type=Path)
    parser.add_argument('question')
    parser.add_argument('--top-k', type=int, default=1)
    args = parser.parse_args()
    clauses = parse_contract(args.file)
    hits = expand_references(retrieve(args.question, clauses, args.top_k), clauses)
    print('학습용 원문 검색입니다. 법률 판단이 아닙니다.')
    for clause in hits:
        print(f"[{clause['id']}] {clause['title']} | {clause['reason']}")
        print(f"{clause['file']}:{clause['start']}-{clause['end']}")
        print(clause['text'])
    if not hits:
        print('관련 조항을 찾지 못했습니다.')


if __name__ == '__main__':
    main()
parse_contract는 “## C02 | 자료 반환” 같은 제목 줄을 찾습니다. 다음 제목 직전까지가 그 조항의 본문입니다. 끝에 붙은 빈 줄은 제외하고, 시작·끝 줄 번호는 원본 파일 기준으로 저장합니다.
파싱 시 다음 입력은 오류로 처리합니다.
- 같은 조항
id가 두 번 나온 경우 - 조항 제목만 있고 본문이 없는 경우
- 제목 형식이 잘못된 경우
@C99처럼 파일에 없는 조항을 참조한 경우
누락된 참조를 조용히 버리면 화면에는 정상적인 검색 결과처럼 보입니다. 하지만 예외나 조건을 담은 조항이 빠져 있을 수 있으므로 이 실습에서는 일찍 멈추도록 했습니다.
REFERENCE 패턴 뒤의 부정형 전방 탐색은 조항 번호 다음에 영문·숫자·밑줄이 더 이어지지 않는지 검사합니다. @C03의처럼 한국어 조사가 붙어도 번호를 잡기 위한 규칙입니다. 단순히 단어 경계인 \b를 붙이면 Python 정규식에서 한글도 단어 문자로 취급되기 때문에 이 예제의 참조를 놓칩니다. Python re 공식 문서
retrieve는 제목과 본문의 단어 겹침을 계산하고 기본적으로 첫 조항 하나를 반환합니다. 형태소 분석은 하지 않으므로 “자료 반환 기간”처럼 문서에 있는 표현을 사용합니다. “돌려주는 기한”과 같은 표현을 같은 뜻으로 판단하지 않습니다.
expand_references는 그다음 단계입니다. 검색된 id를 대기 목록에 넣고, 꺼낸 조항의 참조도 목록에 추가합니다. seen 집합으로 한 번 본 id는 건너뜁니다. C02 → C03 → C02처럼 고리가 있어도 결과가 계속 늘어나지 않습니다.
따라서 top_k가 1이어도 최종 출력은 둘 이상일 수 있습니다. top_k는 최초 검색 개수이고, 연결을 따라 추가한 조항까지 자르는 제한이 아닙니다. 큰 문서에서는 연결된 조항이 많아질 수 있습니다. 처리량 제한을 넣는다면 잘렸다는 상태도 사용자에게 표시해야 합니다.
4. 찾은 근거와 없는 근거 확인하기
세 파일이 있는 폴더에서 실행합니다.
python clause_search.py contract.txt "자료 반환 기간"
글 첫머리처럼 C02와 C03이 함께 나옵니다. C03은 검색어 일치로 고른 것이 아니라 C02가 참조했기 때문에 가져온 결과입니다. reason 필드가 이 차이를 보여줍니다.
없는 주제도 확인합니다.
python clause_search.py contract.txt "항공권"
실제 출력입니다.
학습용 원문 검색입니다. 법률 판단이 아닙니다.
관련 조항을 찾지 못했습니다.
“없다”는 법적 결론으로 읽지 마세요. 현재 검색 규칙으로 결과가 없다는 의미입니다. 문서의 다른 표현, 첨부 문서, 파싱하지 못한 구역은 이 결과만으로 확인할 수 없습니다.
또한 참조 확장은 명시적으로 연결된 방향만 따라갑니다. 다른 조항이 C02를 언급하지만 C02에는 역방향 참조가 없다면, C02 검색에서 그 조항은 자동으로 추가되지 않습니다. 실제 활용에서는 정의·예외·별지의 관계를 어떻게 추출하고 검수할지 별도 설계가 필요합니다.
5. 예외가 빠지면 테스트가 실패하게 만들기
다음을 test_clause_search.py로 저장합니다.
import tempfile
import unittest
from pathlib import Path
from clause_search import parse_contract, retrieve, expand_references


class ClauseSearchTests(unittest.TestCase):
    def setUp(self):
        self.clauses = parse_contract('contract.txt')

    def test_primary_and_exception(self):
        roots = retrieve('자료 반환 기간', self.clauses)
        self.assertEqual(roots, ['C02'])
        hits = expand_references(roots, self.clauses)
        self.assertEqual([hit['id'] for hit in hits], ['C02', 'C03'])
        self.assertIn('14일', hits[0]['text'])
        self.assertIn('적용하지 않는다', hits[1]['text'])

    def test_cycle_stops_and_sources_are_exact(self):
        hits = expand_references(['C02', 'C03'], self.clauses)
        self.assertEqual(len(hits), 2)
        lines = Path('contract.txt').read_text(encoding='utf-8').splitlines()
        for hit in hits:
            self.assertEqual(hit['text'], '\n'.join(lines[hit['start']:hit['end']]))

    def test_unknown_query(self):
        self.assertEqual(retrieve('항공권', self.clauses), [])

    def test_broken_reference_is_rejected(self):
        self.assert_invalid('## C01 | 제목\n다른 조항 @C99 참조.\n')

    def test_duplicate_id_is_rejected(self):
        self.assert_invalid('## C01 | 하나\n본문.\n## C01 | 둘\n본문.\n')

    def test_empty_or_bad_heading_is_rejected(self):
        self.assert_invalid('제목만 있습니다.\n')
        self.assert_invalid('## C01 제목\n본문.\n')
        self.assert_invalid('## C01 | 제목\n')

    def assert_invalid(self, content):
        with tempfile.TemporaryDirectory() as folder:
            path = Path(folder) / 'contract.txt'
            path.write_text(content, encoding='utf-8')
            with self.assertRaises(ValueError):
                parse_contract(path)


if __name__ == '__main__':
    unittest.main()
python -m unittest -v
Python 3.12.14에서 6개 테스트가 통과했습니다. C02 검색 뒤 C03이 포함되는지, 순환 참조가 끝나는지, 원문과 줄 범위가 일치하는지, 누락된 참조와 중복 id를 거부하는지 확인했습니다.
테스트의 기대 결과는 “반환 기간이 14일이라고 답했다”가 아닙니다. C02의 조건과 C03의 예외 원문이 함께 남았는지를 확인합니다. 검색 테스트가 통과해도 실제 계약에 대한 해석의 정확성을 보장하지는 않습니다.
이후 모델을 붙인다면 질문과 이 근거 묶음을 전달할 수 있습니다. 그때도 조항 id를 인용하고, 명시되지 않은 결론은 만들지 않는지 별도로 검수해야 합니다. 이번 편은 그 생성 기능을 구현하거나 시험하지 않았습니다.
직접 바꿔 볼 것
C03에서 새C05조항을 참조하게 만들고,C02검색 시C05까지 따라오는지 테스트를 추가하세요.C03을 지운 뒤 실행하세요. 검색 결과를 조용히 줄이는 대신 오류를 내는 이유를 확인합니다.C04에C02참조를 추가하세요.C02에서C04로는 자동으로 역추적하지 않는다는 점을 확인하고, 양방향 연결이 정말 필요한지 생각해 보세요.- “자료를 돌려주는 기한”으로 검색하세요. 검색 표현이 달라졌을 때의 실패와 조항 연결 누락은 다른 문제임을 구분합니다.
이번 편의 완성 기준은 조항 하나를 찾아내는 것에서 끝나지 않습니다. 그 조항이 직접 가리킨 원문까지 함께 남기고, 끊어진 연결은 오류로 드러나야 합니다.
참고 자료
- Python re: 정규식, 유니코드 단어 문자와 전방 탐색
- Python unittest: 로컬 동작 검증
RAG 실전 포트폴리오 08/25
이전: 07. 코드베이스 검색: 함수 경계와 파일·줄 번호를 함께 남기기