RAG 24. 성능과 비용: 로컬 검색 시간을 재고 호출 예산을 따로 잡자
검색이 느린지, 답변 생성이 비싼지 먼저 나눠 봅니다. 3,000개 가상 문서의 로컬 검색 지연을 실제로 재고, 별도의 가상 요금 계산기로 요청 예산을 제한합니다.
검색이 느린지, 답변 생성이 비싼지 먼저 나눠 봅니다. 3,000개 가상 문서의 로컬 검색 지연을 실제로 재고, 별도의 가상 요금 계산기로 요청 예산을 제한합니다.
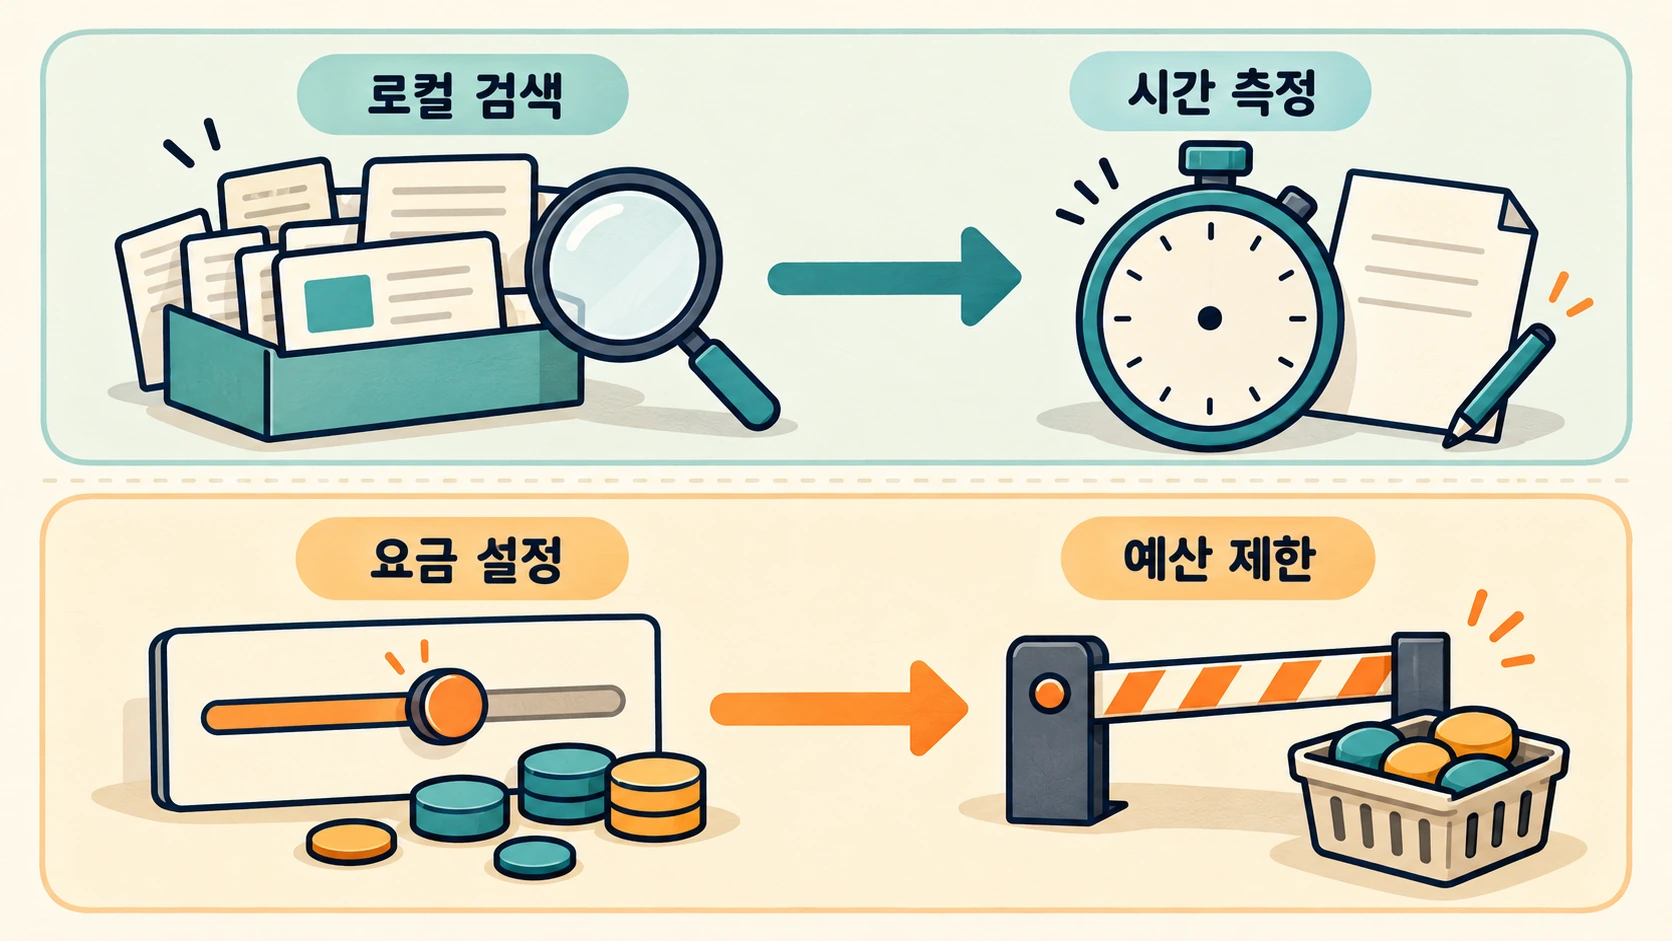
그림은 처리 구조를 설명하는 개념도입니다. 실제 실행 화면이나 측정 결과가 아닙니다.
오늘 만들 결과
매 질문마다 문서를 단어로 나누는 방식과, 미리 나눈 단어를 재사용하는 방식을 비교합니다. 각 방식의 중앙값과 p95를 출력하고 검색 결과가 같은지도 확인합니다. API 비용은 실제 청구액과 구분한 계산 예시로만 보여 줍니다.
먼저 이해할 것
지연 시간(latency)은 한 요청을 처리하는 데 걸린 시간입니다. 중앙값은 측정값을 정렬했을 때 가운데 값이고, p95는 여기서 가까운 순위 방식으로 95% 위치의 값을 고른 것입니다. 40개 측정의 p95는 정렬된 38번째 값입니다. 꼬리 지연을 보는 출발점이지만 이 작은 표본으로 운영 환경을 대표할 수는 없습니다.
캐시는 다시 계산할 값을 저장해 재사용하는 방법입니다. 이번에는 문서의 단어 집합만 미리 저장합니다. 질문 결과 캐시나 임베딩 캐시가 아니며 추가 메모리를 사용합니다. 그 메모리 사용량은 이번 실험에서 재지 않습니다.
API 비용 예산은 검색 시간과 다른 축입니다. 입력 토큰 수, 최대 출력 토큰 수, 단가를 곱해 요청 전 예상 비용을 계산할 수 있습니다. 아래의 1달러·4달러 단가는 특정 서비스의 현재 가격이 아닌 계산 연습용 가정입니다.
실행 준비와 전체 코드
Python 3.12.14에서 실행했습니다. Python 3.12와 표준 라이브러리만 있으면 됩니다. 빈 실습 폴더를 만들고 아래 파일들을 같은 폴더에 저장하세요. 다른 편의 코드나 유료 API 키는 필요하지 않습니다.
기본 실행의 입력 토큰 1,200과 최대 출력 토큰 400도 가정값입니다. 실제 토큰화 결과가 아닙니다. 환경변수 RAG_INPUT_RATE와 RAG_OUTPUT_RATE는 백만 토큰당 USD, RAG_BUDGET_USD는 이번 프로세스의 예산 한도입니다.
performance.py
import math
import os
import platform
import re
import statistics
from decimal import Decimal
from time import perf_counter_ns

DOCUMENTS = [dict(id=str(i), text=(
    'refund window is 14 days' if i % 3 == 0 else
    'shipping takes 3 days' if i % 3 == 1 else 'support office hours weekday'
) + f' item{i}') for i in range(3000)]


def tokens(text):
    return set(re.findall(r'[a-z0-9]+', text.lower()))


def retrieve(question, documents, prepared=None, k=3):
    query = tokens(question)
    corpus = prepared if prepared is not None else [tokens(d['text']) for d in documents]
    scored = [(len(query & terms), index) for index, terms in enumerate(corpus)]
    scored.sort(key=lambda item: (-item[0], item[1]))
    return [documents[index]['id'] for score, index in scored[:k] if score > 0]


def percentile95(values):
    if not values:
        raise ValueError('측정값이 없습니다.')
    return sorted(values)[math.ceil(len(values) * 0.95) - 1]


def nonnegative(value):
    number = Decimal(value)
    if not number.is_finite() or number < 0:
        raise ValueError('음수가 아닌 유한한 비용을 지정하세요.')
    return number


def estimate(input_tokens, max_output_tokens, input_rate, output_rate):
    if any(type(n) is not int or n < 0 for n in (input_tokens, max_output_tokens)):
        raise ValueError('토큰 수 오류')
    return (Decimal(input_tokens) * nonnegative(input_rate)
            + Decimal(max_output_tokens) * nonnegative(output_rate)) / Decimal(1000000)


class Budget:
    def __init__(self, limit):
        self.limit = nonnegative(limit)
        self.reserved = Decimal(0)

    def reserve(self, amount):
        amount = nonnegative(amount)
        if self.reserved + amount > self.limit:
            return False
        self.reserved += amount
        return True


if __name__ == '__main__':
    start = perf_counter_ns()
    prepared = [tokens(d['text']) for d in DOCUMENTS]
    build_ms = (perf_counter_ns() - start) / 1e6
    questions = ['refund days', 'shipping days', 'support hours', 'unknown']
    for _ in range(3):
        for question in questions:
            retrieve(question, DOCUMENTS)
            retrieve(question, DOCUMENTS, prepared)
    times = {'parse_each_query': [], 'prepared_terms': []}
    for repeat in range(40):
        question = questions[repeat % len(questions)]
        modes = [('parse_each_query', None), ('prepared_terms', prepared)]
        if repeat % 2:
            modes.reverse()
        answers = []
        for label, cache in modes:
            start = perf_counter_ns()
            answers.append(retrieve(question, DOCUMENTS, cache))
            times[label].append((perf_counter_ns() - start) / 1e6)
        assert answers[0] == answers[1]
    print(f'Python {platform.python_version()}; docs=3000; samples_per_mode=40; warmup_queries=12')
    print(f'prepare_ms={build_ms:.3f}')
    for label, samples in times.items():
        print(f'{label}: median_ms={statistics.median(samples):.3f} p95_ms={percentile95(samples):.3f}')
    input_rate = os.getenv('RAG_INPUT_RATE', '1.0')
    output_rate = os.getenv('RAG_OUTPUT_RATE', '4.0')
    budget = Budget(os.getenv('RAG_BUDGET_USD', '0.005'))
    cost = estimate(1200, 400, input_rate, output_rate)
    print(f'illustrative estimate_usd={cost:.6f}; limit_usd={budget.limit}')
    for attempt in range(1, 3):
        allowed = budget.reserve(cost)
        print(f'request={attempt} allowed={allowed} reserved_usd={budget.reserved:.6f}')
    print('API calls=0; billed usage not measured')
측정에는 perf_counter_ns를 사용합니다. 문서 단어 집합을 만드는 시간은 prepare_ms로 따로 잽니다. 두 모드를 각각 12번 워밍업한 뒤 같은 질문 순서로 40번 측정합니다. 실행 순서는 번갈아 바꿔 항상 먼저 측정하는 편이 생기지 않도록 했습니다. 매 반복의 assert는 최적화 뒤 결과가 같다는 최소 검증입니다.
prepared_terms도 모든 문서를 훑고 정렬합니다. 미리 단어를 나누어 반복 작업을 줄였을 뿐, 역색인이나 대규모 벡터 검색 엔진이 된 것은 아닙니다. 시작 비용·메모리·갱신 비용을 함께 고려해야 합니다.
estimate는 Decimal로 비용을 계산하고 Budget은 호출 전에 예상치를 예약합니다. 예약 뒤 남은 한도가 부족하면 다음 요청을 막습니다. 여기에는 외부 API가 연결되어 있지 않습니다. 실제 운영에서는 시스템 지시·근거·도구 스키마 등 모든 입력, 모델별 청구 항목과 토큰 계산을 포함해야 합니다. 추정치가 실제 비용의 상한이 된다는 보장도 없습니다.
예약 금액은 사용 완료 뒤 실제 청구 사용량과 정산해야 합니다. 현재 Budget은 단일 프로세스 메모리 변수라 동시 요청·재시작·다른 서버에 걸친 예산을 보장하지 않습니다. 공용 예산은 원자적 저장소와 공급자 사용 한도 등 추가 장치가 필요합니다.
직접 실행한 결과
python performance.py
아래는 이 글의 가상 데이터로 로컬에서 실제 실행한 출력입니다. 언어 모델이나 임베딩 API를 호출한 결과가 아닙니다.
Python 3.12.14; docs=3000; samples_per_mode=40; warmup_queries=12
prepare_ms=4.469
parse_each_query: median_ms=4.619 p95_ms=4.900
prepared_terms: median_ms=0.875 p95_ms=1.216
illustrative estimate_usd=0.002800; limit_usd=0.005
request=1 allowed=True reserved_usd=0.002800
request=2 allowed=False reserved_usd=0.002800
API calls=0; billed usage not measured
위 시간은 이 글을 실행한 로컬 환경의 관측값입니다. CPU·가상화·부하에 따라 달라집니다. 네트워크, 임베딩, 언어 모델 생성 시간은 포함하지 않습니다. 비용 부분은 가상 단가의 산술 결과이며 API 호출 수는 0입니다.
테스트로 경계를 고정하기
다음을 test_example.py로 저장합니다.
import unittest
from decimal import Decimal
from performance import Budget, DOCUMENTS, estimate, percentile95, retrieve, tokens


class PerformanceTests(unittest.TestCase):
    def test_same_results(self):
        prepared = [tokens(d['text']) for d in DOCUMENTS]
        for question in ('refund days', 'support hours', 'unknown'):
            self.assertEqual(retrieve(question, DOCUMENTS), retrieve(question, DOCUMENTS, prepared))

    def test_cost_formula(self):
        self.assertEqual(estimate(1200, 400, '1', '4'), Decimal('0.0028'))

    def test_budget_prevents_second_reservation(self):
        budget = Budget('0.005')
        self.assertTrue(budget.reserve('0.0028'))
        self.assertFalse(budget.reserve('0.0028'))
        self.assertEqual(budget.reserved, Decimal('0.0028'))

    def test_invalid_budget_rejected(self):
        for value in ('-1', 'NaN', 'Infinity'):
            with self.assertRaises(ValueError):
                Budget(value)

    def test_p95_definition(self):
        self.assertEqual(percentile95(list(range(1, 101))), 95)


if __name__ == '__main__':
    unittest.main()
python -m unittest -v
다섯 테스트가 최적화 전후 결과 일치, 가상 비용 공식, 한도 초과 방지, 잘못된 금액, p95 계산을 검사합니다. 시간 값 자체는 장비마다 달라지므로 고정 숫자와 같아야 한다는 테스트는 넣지 않았습니다.
test_budget_prevents_second_reservation (test_example.PerformanceTests.test_budget_prevents_second_reservation) ... ok
test_cost_formula (test_example.PerformanceTests.test_cost_formula) ... ok
test_invalid_budget_rejected (test_example.PerformanceTests.test_invalid_budget_rejected) ... ok
test_p95_definition (test_example.PerformanceTests.test_p95_definition) ... ok
test_same_results (test_example.PerformanceTests.test_same_results) ... ok

----------------------------------------------------------------------
Ran 5 tests in 0.027s

OK
직접 바꿔 볼 것
- 문서 수를 30,000으로 늘리고
prepare_ms와 요청 지연을 함께 기록하세요. 이전 출력 숫자를 그대로 재사용하지 마세요. - 측정 결과를 비교할 때 Python 버전, 문서 수, 반복 수, 실행 환경과 다른 작업의 부하를 남기세요. 로컬 단어 검색 지연을 모델 API 지연으로 소개하면 안 됩니다.
RAG_BUDGET_USD를 0.01로 설정해 두 예약이 허용되는지 확인하세요. 단가는 실제 서비스를 연결할 때 공식 요금표로 갱신하세요.- 캐시를 문서
id·버전과 연결하고, 문서가 바뀌었는데 예전 단어 집합을 쓰는 테스트를 추가하세요.
참고 자료
- Python perf_counter: 짧은 구간 측정용 고해상도 시계.
- Python statistics: 중앙값 계산.
RAG 실전 포트폴리오 24/25
이전: 23. 프롬프트 인젝션: 문서의 지시를 데이터로 다루고 출력을 제한하기