RAG 20. 평가 대시보드: 정답 질문으로 Recall과 실패 사례 함께 보기
검색 방식을 바꾸기 전후에 같은 질문을 실행하고, 어떤 질문이 좋아졌는지 파일로 남깁니다. 손으로 정답을 붙인 여섯 질문으로 검색 지표를 직접 계산하고 로컬 HTML 대시보드를 만듭니다.
검색 방식을 바꾸기 전후에 같은 질문을 실행하고, 어떤 질문이 좋아졌는지 파일로 남깁니다. 손으로 정답을 붙인 여섯 질문으로 검색 지표를 직접 계산하고 로컬 HTML 대시보드를 만듭니다.
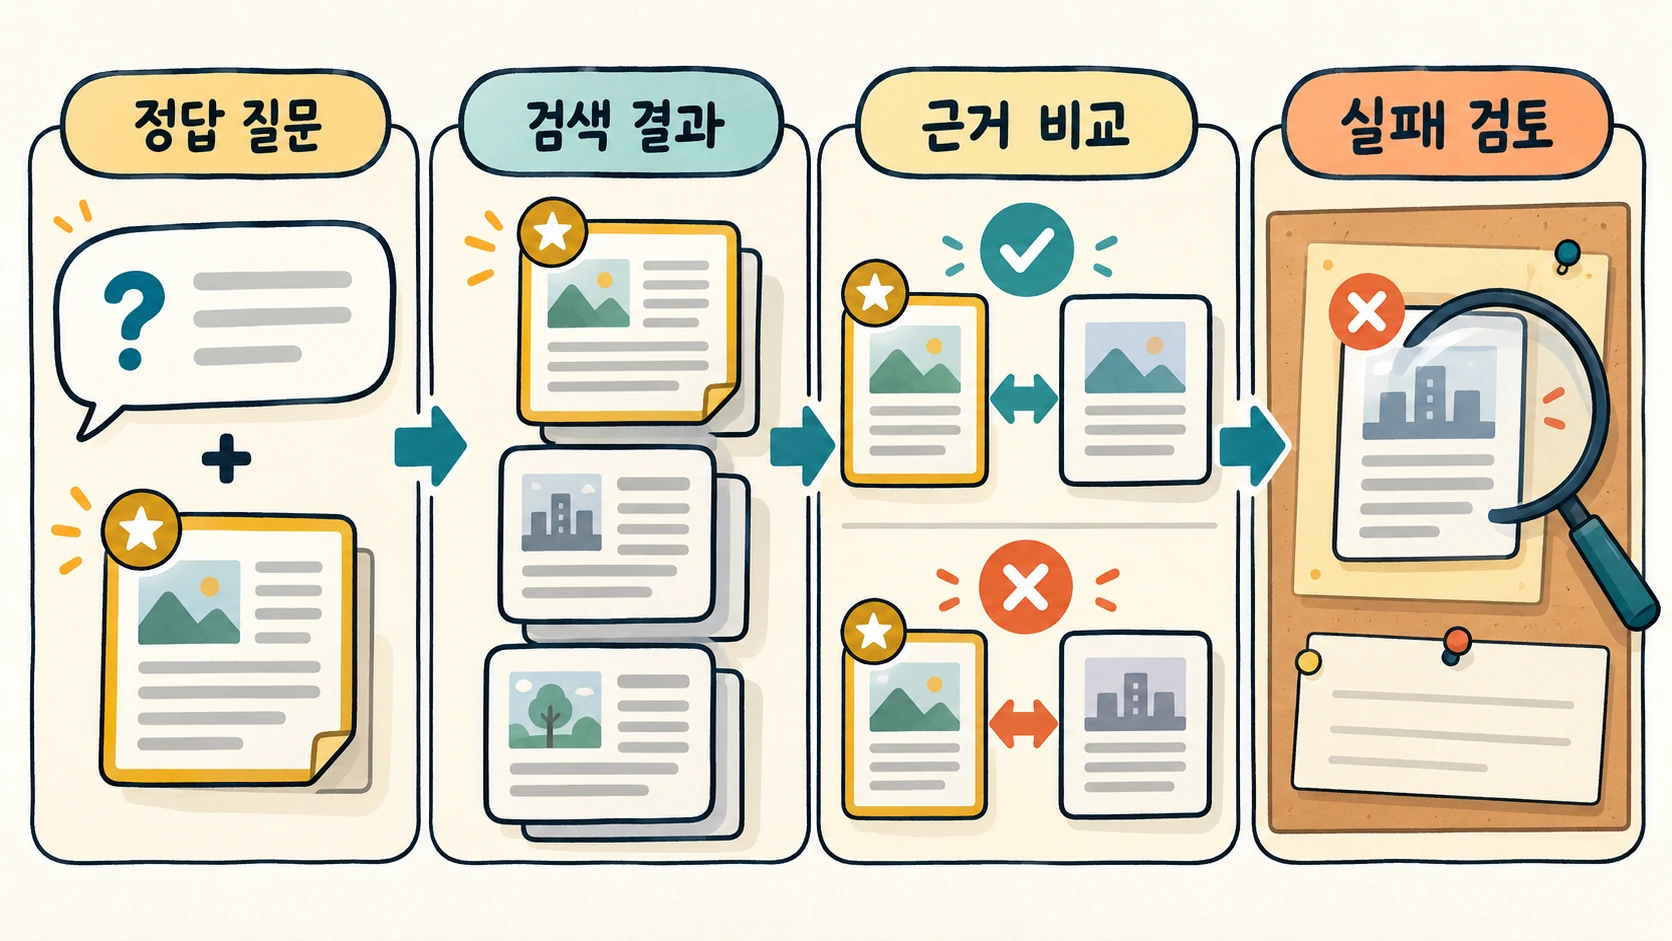
그림은 처리 구조를 설명하는 개념도입니다. 실제 실행 화면이나 측정 결과가 아닙니다.
오늘 만들 결과
동의어 확장 전후의 Recall@2와 MRR@2, 답할 수 없는 질문의 검색 거절 비율을 계산합니다. dashboard.html에는 평균값뿐 아니라 질문별 정답 id와 실제 검색 id가 들어갑니다. 외부 호스팅 없이 파일을 브라우저에서 열 수 있습니다.
먼저 이해할 것
골드(gold) 데이터는 사람이 정답으로 지정한 기준 자료입니다. 여기서는 질문마다 관련 문서 id의 집합을 붙입니다. d1처럼 정답 문서가 하나인 질문도 있고, 현재 문서 묶음으로 답할 수 없어 정답 집합이 빈 질문도 있습니다.
Recall@2는 정답 문서 중 상위 두 검색 결과에 들어온 비율입니다. MRR@2는 상위 두 결과에서 첫 정답의 순위에 역수를 취한 뒤 평균을 냅니다. 첫 번째면 1, 두 번째면 0.5, 없으면 0입니다. 이 글에서는 두 지표를 답할 수 있는 네 질문에만 계산합니다.
답할 수 없는 두 질문은 별도로 평가합니다. 검색 결과를 비워 반환한 비율을 correct_abstention이라고 이름 붙였습니다. 모델의 답변 거절 능력이 아니라 검색 단계의 거절 비율입니다. 실제 생성 답변의 정확성이나 근거 충실도는 이 실습에서 측정하지 않습니다.
실행 준비와 전체 코드
Python 3.12.14에서 실행했습니다. Python 3.12와 표준 라이브러리만 있으면 됩니다. 빈 실습 폴더를 만들고 아래 파일들을 같은 폴더에 저장하세요. 다른 편의 코드나 유료 API 키는 필요하지 않습니다.
코드 안의 DOCUMENTS와 GOLD가 전체 입력입니다. 실행하면 같은 폴더의 dashboard.html과 results.json을 새로 쓰거나 덮어씁니다.
evaluate.py
import html
import json
import re
from pathlib import Path

DOCUMENTS = {
    'd1': 'refund policy 14 days',
    'd2': 'receipt required for refund policy',
    'd3': 'shipping takes 3 days',
    'd4': 'support office hours weekday',
}
GOLD = [
    ('refund days', {'d1'}), ('return receipt', {'d2'}),
    ('parcel transit', {'d3'}), ('opening time', {'d4'}),
    ('bitcoin price', set()), ('warranty refund', set()),
]
ALIASES = {'return': 'refund', 'parcel': 'shipping', 'transit': 'shipping',
           'opening': 'hours', 'time': 'hours'}


def tokens(text):
    return set(re.findall(r'[a-z]+', text.lower()))


def retrieve(question, expanded=False, k=2):
    terms = tokens(question)
    if expanded:
        terms |= {ALIASES[t] for t in terms if t in ALIASES}
    scores = [(len(terms & tokens(text)), doc_id) for doc_id, text in DOCUMENTS.items()]
    return [doc_id for score, doc_id in sorted(scores, key=lambda x: (-x[0], x[1]))[:k] if score]


def evaluate(expanded=False):
    rows, recalls, reciprocal_ranks, rejections = [], [], [], []
    for question, relevant in GOLD:
        hits = retrieve(question, expanded)
        if relevant:
            recall = len(set(hits) & relevant) / len(relevant)
            rr = next((1 / rank for rank, doc_id in enumerate(hits, 1)
                       if doc_id in relevant), 0.0)
            recalls.append(recall)
            reciprocal_ranks.append(rr)
        else:
            recall = rr = None
            rejections.append(float(not hits))
        rows.append(dict(question=question, gold=sorted(relevant), hits=hits,
                         recall=recall, reciprocal_rank=rr))
    metrics = dict(answerable_queries=len(recalls), unanswerable_queries=len(rejections),
                   recall_at_2=sum(recalls)/len(recalls),
                   mrr_at_2=sum(reciprocal_ranks)/len(reciprocal_ranks),
                   correct_abstention=sum(rejections)/len(rejections))
    return dict(metrics=metrics, rows=rows)


def dashboard(results, path):
    panels = []
    for name, result in results.items():
        rows = ''.join('<tr>'+''.join('<td>'+html.escape(str(value))+'</td>' for value in
                       (r['question'], r['gold'], r['hits'], r['recall']))+'</tr>'
                       for r in result['rows'])
        metrics = html.escape(json.dumps(result['metrics'], ensure_ascii=False, indent=2))
        panels.append(f'<h2>{html.escape(name)}</h2><pre>{metrics}</pre>'
                      '<table><tr><th>질문</th><th>정답</th><th>검색</th><th>Recall</th></tr>'
                      +rows+'</table>')
    Path(path).write_text('<!doctype html><meta charset="utf-8"><title>검색 평가</title>'
                         '<style>body{max-width:900px;margin:32px auto;font:16px sans-serif}'
                         'td,th{border:1px solid #ccc;padding:8px}table{border-collapse:collapse}'
                         'pre{white-space:pre-wrap}</style><h1>가상 질문 6개 검색 평가</h1>'
                         +''.join(panels), encoding='utf-8')


if __name__ == '__main__':
    results = {'baseline': evaluate(False), 'expanded': evaluate(True)}
    for name, result in results.items():
        print(name, json.dumps(result['metrics'], ensure_ascii=False))
    dashboard(results, 'dashboard.html')
    Path('results.json').write_text(json.dumps(results, ensure_ascii=False, indent=2), encoding='utf-8')
    print('saved: dashboard.html, results.json')
retrieve는 단어 교집합 점수로 문서를 정렬하고, 동점일 때 id 순서를 사용합니다. expanded=True에서는 return을 refund로, parcel을 shipping으로 확장합니다. 이 규칙을 사전이라고 부를 수 있지만 학습한 임베딩 모델은 아닙니다.
evaluate는 각 질문에서 실제로 반환된 id로 지표를 계산합니다. 숫자를 보기 좋게 적어 두는 방식이 아닙니다. rows에 실패 사례를 남겨서 전체 평균이 올라도 특정 질문이 나빠졌는지 볼 수 있습니다. HTML에는 html.escape를 적용해 질문에 꺾쇠가 있어도 태그로 실행되지 않도록 합니다.
이 여섯 질문은 사전 규칙을 설명하기 위한 작은 고정 예제입니다. 확장 규칙을 만들 때 이미 본 질문이므로 독립적인 검증 집합으로 볼 수 없습니다. 실제 비교에서는 튜닝용 질문과 최종 검증용 질문을 분리하고, 데이터·분할 규칙·모델·검색 설정 버전도 결과와 함께 기록하세요.
직접 실행한 결과
python evaluate.py
아래는 이 글의 가상 데이터로 로컬에서 실제 실행한 출력입니다. 언어 모델이나 임베딩 API를 호출한 결과가 아닙니다.
baseline {"answerable_queries": 4, "unanswerable_queries": 2, "recall_at_2": 0.5, "mrr_at_2": 0.5, "correct_abstention": 0.5}
expanded {"answerable_queries": 4, "unanswerable_queries": 2, "recall_at_2": 1.0, "mrr_at_2": 1.0, "correct_abstention": 0.5}
saved: dashboard.html, results.json
이번 실제 계산에서 Recall@2는 0.5에서 1.0으로 올랐지만 검색 거절 비율은 0.5로 그대로입니다. warranty refund가 여전히 잘못 검색됩니다. 작은 예제의 1.0을 서비스 전체 정확도 100%라고 표현하면 안 됩니다.
테스트로 경계를 고정하기
다음을 test_example.py로 저장합니다.
import tempfile
import unittest
from pathlib import Path
from evaluate import evaluate, dashboard
class EvaluationTests(unittest.TestCase):
def test_baseline_metrics(self):
metrics = evaluate()['metrics']
self.assertEqual(metrics['recall_at_2'], 0.5)
self.assertEqual(metrics['mrr_at_2'], 0.5)
self.assertEqual(metrics['correct_abstention'], 0.5)
def test_expansion_retrieves_aliases(self):
result = evaluate(True)
self.assertEqual(result['metrics']['recall_at_2'], 1.0)
self.assertEqual(result['metrics']['mrr_at_2'], 1.0)
self.assertEqual(result['rows'][2]['hits'], ['d3'])
def test_unknown_failure_remains_visible(self):
result = evaluate(True)
self.assertTrue(result['rows'][-1]['hits'])
self.assertEqual(result['metrics']['correct_abstention'], 0.5)
def test_dashboard_escapes_text(self):
result = evaluate()
result['rows'][0]['question'] = '<script>alert(1)</script>'
with tempfile.TemporaryDirectory() as folder:
path = Path(folder)/'dashboard.html'
dashboard({'baseline': result}, path)
content = path.read_text()
self.assertIn('<script>', content)
self.assertNotIn('<script>', content)
if __name__ == '__main__':
unittest.main()
python -m unittest -v
네 테스트가 지표 계산, 동의어 검색, 남아 있는 오검색, HTML 문자 이스케이프를 확인합니다. HTML 파일 생성은 확인했지만 이 글의 검증에서 브라우저 화면을 시각 검수하지는 않았습니다.
test_baseline_metrics (test_example.EvaluationTests.test_baseline_metrics) ... ok
test_dashboard_escapes_text (test_example.EvaluationTests.test_dashboard_escapes_text) ... ok
test_expansion_retrieves_aliases (test_example.EvaluationTests.test_expansion_retrieves_aliases) ... ok
test_unknown_failure_remains_visible (test_example.EvaluationTests.test_unknown_failure_remains_visible) ... ok

----------------------------------------------------------------------
Ran 4 tests in 0.001s

OK
직접 바꿔 볼 것
- 정답 문서가 두 개인 질문을 추가하고 Recall이 0.5가 되는 경우를 만드세요.
k를 1로 줄이면 지표 이름과 계산을 함께 바꾸세요. 이름만 Recall@2로 남기면 실험 기록을 오해하게 됩니다.warranty refund가 왜 검색되는지 결과 행에서 확인하세요. 무작정 동의어를 늘리는 것과 질문 의도 판별은 다른 문제입니다.- 새 검증 질문은 규칙을 수정하기 전에 고정하세요. 질문 수와 답변 가능한 질문 비중도 지표 옆에 표시하세요.
참고 자료
- Python unittest: 회귀 테스트 실행 방법.
- Python html.escape: 문자를 HTML 텍스트로 안전하게 표시하는 함수.
RAG 실전 포트폴리오 20/25
이전: 19. 실시간 문서 수집: 늦게 온 이벤트와 오래된 근거 구분하기