RAG 21. 문서 갱신: 같은 내용은 건너뛰고 오래된 청크는 지우자
문서를 다시 넣을 때 청크가 계속 늘어나거나, 삭제한 문장이 검색에 남는 문제를 막습니다. 내용 해시와 SQLite 트랜잭션으로 한 문서의 청크를 통째로 안전하게 교체합니다.
문서를 다시 넣을 때 청크가 계속 늘어나거나, 삭제한 문장이 검색에 남는 문제를 막습니다. 내용 해시와 SQLite 트랜잭션으로 한 문서의 청크를 통째로 안전하게 교체합니다.
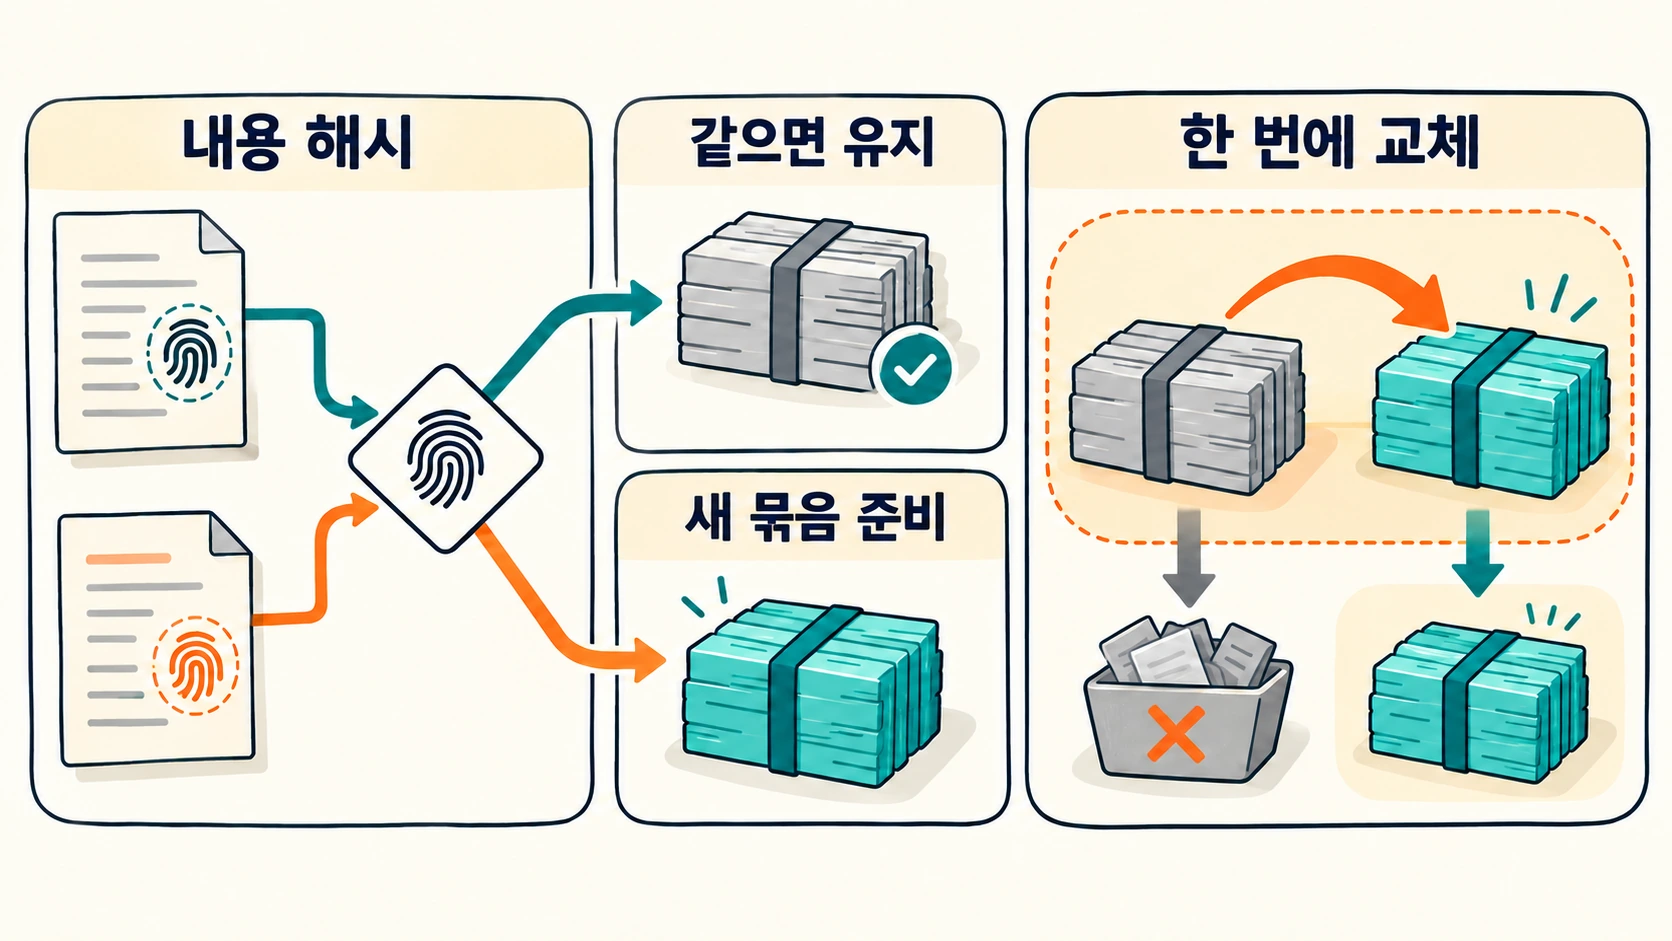
그림은 처리 구조를 설명하는 개념도입니다. 실제 실행 화면이나 측정 결과가 아닙니다.
오늘 만들 결과
같은 문서를 두 번 넣으면 두 번째에는 unchanged가 나옵니다. 두 문단 문서를 한 문단으로 고치면 예전 두 청크가 사라지고 새 청크만 남습니다. 도중에 저장 오류가 나면 이전 문서 상태로 되돌아갑니다.
먼저 이해할 것
멱등성(idempotency)은 같은 작업을 여러 번 실행해도 결과가 더 변하지 않는 성질입니다. 수집 이벤트는 재시도될 수 있으므로 중복 입력을 정상적인 상황으로 취급해야 합니다.
해시(hash)는 내용을 고정 길이 값으로 바꾸는 함수입니다. 여기서는 SHA-256으로 정규화한 본문과 청크 분할 버전을 함께 계산합니다. 원문이 같아도 분할 규칙을 바꾸면 청크를 다시 만들어야 하므로 CHUNKER_VERSION이 들어갑니다. 해시는 변경 감지 도구이지 접근 권한 검사나 암호화가 아닙니다.
트랜잭션은 여러 데이터 변경을 하나의 성공 또는 실패로 묶습니다. 새 문서 정보 저장, 기존 청크 삭제, 새 청크 삽입이 전부 끝나야 갱신을 확정합니다. 중간에 실패하면 예전 청크 삭제까지 취소되어야 합니다.
실행 준비와 전체 코드
Python 3.12.14에서 실행했습니다. Python 3.12와 표준 라이브러리만 있으면 됩니다. 빈 실습 폴더를 만들고 아래 파일들을 같은 폴더에 저장하세요. 다른 편의 코드나 유료 API 키는 필요하지 않습니다.
기본 실행은 :memory: 데이터베이스를 사용합니다. 디스크에 남기려면 connect("index.db")로 바꾸세요. 처음 실행 시 테이블이 만들어집니다.
updates.py
import hashlib
import json
import sqlite3

CHUNKER_VERSION = 'paragraph-v1'


def connect(path=':memory:'):
    db = sqlite3.connect(path)
    db.execute('PRAGMA foreign_keys = ON')
    db.executescript("""
        CREATE TABLE IF NOT EXISTS documents (
            id TEXT PRIMARY KEY, digest TEXT NOT NULL);
        CREATE TABLE IF NOT EXISTS chunks (
            id TEXT PRIMARY KEY, document_id TEXT NOT NULL,
            ordinal INTEGER NOT NULL, text TEXT NOT NULL,
            FOREIGN KEY(document_id) REFERENCES documents(id) ON DELETE CASCADE);
    """)
    return db


def normalize(text):
    return text.replace('\r\n', '\n').replace('\r', '\n').strip()


def update_document(db, document_id, text):
    normalized = normalize(text)
    payload = json.dumps([CHUNKER_VERSION, normalized], ensure_ascii=False).encode()
    digest = hashlib.sha256(payload).hexdigest()
    pieces = [part.strip() for part in normalized.split('\n\n') if part.strip()]
    with db:
        old = db.execute('SELECT digest FROM documents WHERE id=?', (document_id,)).fetchone()
        if old and old[0] == digest:
            return 'unchanged'
        db.execute('INSERT INTO documents(id,digest) VALUES(?,?) '
                   'ON CONFLICT(id) DO UPDATE SET digest=excluded.digest', (document_id, digest))
        db.execute('DELETE FROM chunks WHERE document_id=?', (document_id,))
        for ordinal, piece in enumerate(pieces):
            chunk_id = json.dumps([document_id, digest, ordinal], ensure_ascii=False)
            db.execute('INSERT INTO chunks VALUES(?,?,?,?)',
                       (chunk_id, document_id, ordinal, piece))
    return f'updated:{len(pieces)}'


def delete_document(db, document_id):
    with db:
        db.execute('DELETE FROM documents WHERE id=?', (document_id,))


def read_chunks(db, document_id):
    return [row[0] for row in db.execute(
        'SELECT text FROM chunks WHERE document_id=? ORDER BY ordinal', (document_id,))]


if __name__ == '__main__':
    db = connect()
    for text in ('환불은 14일 이내.\n\n영수증 필요.', '환불은 14일 이내.\n\n영수증 필요.',
                 '환불은 30일 이내.'):
        print(update_document(db, 'policy', text), read_chunks(db, 'policy'))
    delete_document(db, 'policy')
    print('deleted:', read_chunks(db, 'policy'))
    db.close()
normalize는 줄바꿈 형식을 맞추고 문서 앞뒤 공백을 제거합니다. 내부 문단의 공백까지 무조건 없애지는 않습니다. 표·코드처럼 공백이 의미 있는 문서는 더 신중한 정규화가 필요합니다.
update_document의 with db 범위가 트랜잭션입니다. 내용이 같으면 쓰지 않고 끝냅니다. 달라졌으면 해당 document_id의 청크를 삭제하고 새 목록을 넣습니다. SQL의 물음표 자리표시자로 값을 전달하므로 문서 본문을 SQL 문자열에 이어 붙이지 않습니다. 청크 id에는 문서 id, 해시 전체, 문단 순번을 넣습니다.
외래 키의 ON DELETE CASCADE는 문서를 지울 때 그 문서의 청크도 지웁니다. SQLite에서는 연결마다 foreign_keys를 켜는 코드를 빠뜨리지 않습니다. 다른 문서의 청크는 남아야 하므로 삭제 조건도 테스트합니다.
이 예제는 한 작성자의 순차 갱신을 다룹니다. 동시에 여러 수집기가 같은 문서를 수정한다면 최신 버전 조건과 재시도 규칙을 추가해야 합니다. 외부 벡터 데이터베이스와 SQLite를 함께 쓰면 두 저장소를 이 트랜잭션 하나로 묶을 수 없으므로 별도 일관성 설계가 필요합니다.
직접 실행한 결과
python updates.py
아래는 이 글의 가상 데이터로 로컬에서 실제 실행한 출력입니다. 언어 모델이나 임베딩 API를 호출한 결과가 아닙니다.
updated:2 ['환불은 14일 이내.', '영수증 필요.']
unchanged ['환불은 14일 이내.', '영수증 필요.']
updated:1 ['환불은 30일 이내.']
deleted: []
테스트로 경계를 고정하기
다음을 test_example.py로 저장합니다.
import sqlite3
import unittest
from updates import connect, update_document, read_chunks, delete_document


class UpdateTests(unittest.TestCase):
    def setUp(self):
        self.db = connect()

    def tearDown(self):
        self.db.close()

    def test_idempotent_update(self):
        update_document(self.db, 'a', 'first\n\nsecond')
        ids = self.db.execute('SELECT id FROM chunks ORDER BY ordinal').fetchall()
        self.assertEqual(update_document(self.db, 'a', 'first\n\nsecond'), 'unchanged')
        self.assertEqual(ids, self.db.execute('SELECT id FROM chunks ORDER BY ordinal').fetchall())

    def test_replace_removes_stale_chunks(self):
        update_document(self.db, 'a', 'old\n\nstale')
        update_document(self.db, 'a', 'new')
        self.assertEqual(read_chunks(self.db, 'a'), ['new'])

    def test_failed_insert_rolls_back_everything(self):
        update_document(self.db, 'a', 'original')
        self.db.execute("CREATE TRIGGER reject_bad BEFORE INSERT ON chunks "
                        "WHEN NEW.text='BAD' BEGIN SELECT RAISE(ABORT,'bad'); END")
        with self.assertRaises(sqlite3.IntegrityError):
            update_document(self.db, 'a', 'new\n\nBAD')
        self.assertEqual(read_chunks(self.db, 'a'), ['original'])
        self.assertEqual(update_document(self.db, 'a', 'original'), 'unchanged')

    def test_delete_cascades_but_keeps_other_document(self):
        update_document(self.db, 'a', 'first')
        update_document(self.db, 'b', 'second')
        delete_document(self.db, 'a')
        self.assertEqual(read_chunks(self.db, 'a'), [])
        self.assertEqual(read_chunks(self.db, 'b'), ['second'])

    def test_line_ending_normalization(self):
        update_document(self.db, 'a', 'one\r\n\r\ntwo')
        self.assertEqual(update_document(self.db, 'a', 'one\n\ntwo'), 'unchanged')


if __name__ == '__main__':
    unittest.main()
python -m unittest -v
다섯 테스트 중 롤백 검사는 BAD 청크 삽입을 의도적으로 실패시킵니다. 예전 본문뿐 아니라 해시도 복원되는지 확인합니다.
test_delete_cascades_but_keeps_other_document (test_example.UpdateTests.test_delete_cascades_but_keeps_other_document) ... ok
test_failed_insert_rolls_back_everything (test_example.UpdateTests.test_failed_insert_rolls_back_everything) ... ok
test_idempotent_update (test_example.UpdateTests.test_idempotent_update) ... ok
test_line_ending_normalization (test_example.UpdateTests.test_line_ending_normalization) ... ok
test_replace_removes_stale_chunks (test_example.UpdateTests.test_replace_removes_stale_chunks) ... ok

----------------------------------------------------------------------
Ran 5 tests in 0.002s

OK
직접 바꿔 볼 것
- 세 문단을 넣은 뒤 첫 문단만 남기세요. 삭제된 문장이 데이터베이스에 없는지
SELECT로 확인하세요. CHUNKER_VERSION을 바꾸면 같은 본문도 다시 분할되는지 테스트하세요.- 빈 문자열 입력을 문서 삭제로 볼지, 빈 문서로 보관할지 정하세요. 현재 코드는 문서 행은 남기고 청크를 0개로 만듭니다.
- 실제 파일 감시를 연결할 때 파일 이름 변경과 문서 식별자 변경을 구분하세요. 이름이 바뀌었다고 원래 문서 청크를 방치하면 안 됩니다.
참고 자료
- Python sqlite3 트랜잭션: 연결 컨텍스트 관리자와 매개변수 바인딩.
- SQLite 외래 키: 외래 키 활성화와 ON DELETE CASCADE.
RAG 실전 포트폴리오 21/25
이전: 20. 평가 대시보드: 정답 질문으로 Recall과 실패 사례 함께 보기